【ZOL中关村在线原创技术解析】近日,面壁智能发布MiniCPM-V 4.7(35B-A3B)MoE模型,该款总参数35B、每次激活约3B参数的混合专家模型,在手机端的实时速度跃升至30 Token/s以上,且模型精度几乎无损。这一表现不仅跨过了端侧实时流畅交互的体验门槛,其综合多模态智能水平也已超越2023年的云端旗舰标杆GPT-4V。
图源:面壁智能
1 智能演进的底层逻辑是供需“撞线”
人类社会究竟需要什么样的智能技术?在面壁智能联席首席科学家姚远看来,回顾商业航空、电池乃至计算机工业的演进史,所有成功的技术最终都指向三个共同特征:强大、高效、普惠。计算从大型机走向个人设备的历程,为智能的演进提供了最直接的参照。
从需求侧来看,用户天然倾向于将计算留在身边的个人设备上,这不仅出于隐私安全、断网可用、低延迟交互和零云端算力成本等显性考量,更源于个人设备“专属、随时可用”的掌控感。
“早期一台个人电脑的全部内存只有256KB,一个稍大的数组就会撑爆内存,当时预判全世界只靠5台大型主机似乎并不离谱。”姚远指出,随着摩尔定律推动硬件计算密度持续爬升,每当技术供给突破某一场景的最低需求门槛,即供给线与需求线发生“撞线”,产业就会迎来从大型机时代向PC时代、再向移动互联网时代的代际跨越。
在人工智能领域,当前的端侧智能正处于类似的“256KB内存PC时代”。姚远表示,用户的智能需求同样分为两类:一类是编写超大型软件、设计先进芯片等几乎没有能力上限的极限任务;另一类则是绝大多数人日常高频使用的、需求水位相对恒定的任务。
近年来,端侧模型的能力边界已从早期的简单文本续写、信息抽取、改写摘要,一路突破至多模态图文视频理解乃至初步的工具调用。当端侧供给的智能水平越过日常任务的恒定水位线时,智能从云端向终端的迁移便会自然发生。
2 “三驾马车”协同提速,端侧智能迎来等智能线交汇
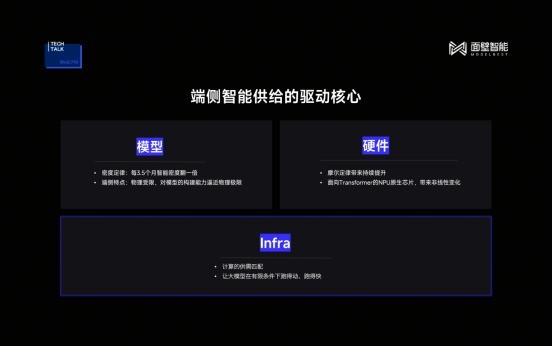
要加速端侧智能跨过需求门槛,底层供给靠什么支撑?姚远将其归结为端侧智能的“三驾马车”:模型、硬件与Infra。
图源:面壁智能
其中,模型直接产生智能,硬件提供算力底座,除了摩尔定律的常规演进,面向Transformer架构的原生NPU芯片正带来非线性提升;而Infra则让大模型在有限的终端硬件条件下真正“跑得动、跑得快”。模型一侧的驱动力,来自面壁智能提出的 "密度定律"—— 每 3.5 个月,智能密度翻一番。姚远表示,端侧模型要在首响延迟、推理速度、功耗等物理约束下运行,因此模型设计的基本原则就是逼近物理极限,在同样的设备条件下实现更高的智能水平。
一款35B规模的模型即便采用较为激进的Q4量化,权重体积仍高达15GB;而目前主流的12GB内存手机,扣除系统预留后最多仅有8GB可用内存,若考虑多应用后台共存,留给大模型的合理内存空间往往只有3GB左右,很难实现流畅的运行效果。
为了打破这一物理瓶颈,MiniCPM-V 4.7(35B-A3B)MoE模型拥有着由大量独立并行专家组成、每次仅激活少数专家的结构特点,将模型专家权重默认存放在闪存中,仅在计算时按需加载至内存,以提高闪存读取效率。
在本次将35B模型推上手机的过程中,Infra层面的核心突破是前瞻专家调度(LES)技术。在保障模型输出质量不打折、且内存占用严格锁定在3GB的前提下,这套Infra方案加持下的MiniCPM-V 4.7(35B-A3B)MoE实测生成速度已跃升至30 Token/s以上。
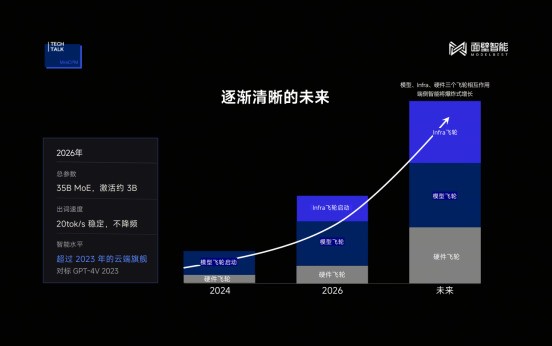
姚远表示,当硬件、模型与Infra三个飞轮形成深度协同设计时,端侧智能的供给增速将达到7至8倍以上,行业中端侧智能参数规模正随时间快速下探;与此同时,端侧设备可有效承载的模型尺寸上限则在稳步抬升。
图源:面壁智能
当参数规模与有效承载发生交汇,意味着昔日云端旗舰的智能水平将在端侧落地。姚远指出,如果以GPT-4V、GPT-4o乃至Claude Opus 4.5的能力水位作为参照,“等智能线”与端侧承载力的交汇其实已经发生;若以未来的GPT-6为参照,这一交汇也在快速逼近。
3 两年内,端侧模型有望实现GPT-6级能力
今年无论苹果、谷歌还是国内的阿里千问,都在密集争夺端侧大模型的落地入口,手机与芯片大厂也纷纷下场自研。群访一开始,就有媒体把核心疑问抛给了姚远:在大厂环伺、且云端API调用价格一降再降的当下,独立模型厂商做端侧的护城河究竟在哪?训得好云端大模型的团队,难道做不好端侧吗?
姚远从两者之间的底层物理约束差异给出了回答:“云端模型更多时候服务高并发状态,没有那么多物理限制,大家可以通过抬高容量去把事情服务好;但端侧完全是另一套逻辑,你必须非常贴合终端硬件的物理极限去设计,训得好云端模型未必擅长训端侧模型。”
他解释,端侧的护城河不在单点拼模型,而是“模型+硬件理解+Infra”的全栈系统工程比拼。过去行业常误以为端侧就是单纯“把模型做小”,但面壁的逻辑始终是“在端侧提供最强的智能”,一方面提高智能密度做普惠,另一方面吃满新一代硬件算力去跑35B这样更大的旗舰模型。
至于“云端越来越便宜,为什么非用端侧不可”的商业化问题,姚远也给出了一些如今端侧模型的刚需场景,比如汽车开进隧道不能断联,很多用户为了杜绝隐私上云,会主动把电子设备的摄像头盖上;而在手机端,最基础的通话语音实时转录涉及家人私密对话或公司高密信息,用户天然抗拒上传云端。
因此,虽然产业终局必然是“端云协同”,但分界线还是比较清晰的,数据量庞大、高频发生的多模态信息优先留在本地处理;只有经过本地高度抽象、完成脱敏的复杂逻辑推理,才交由云端协同。
那么,端侧智能的能力究竟能涨多快?面对媒体的追问,姚远预判未来两到三年内,GPT-6级别的旗舰能力将在手机的3GB内存里流畅跑起来。“就像摩尔定律把底层驱动力的增长汇总成一个经验观察点一样,过去每一代云端旗舰模型,基本上两年内我们都能完成端侧落地。”
姚远坦言,回过头看,面壁团队自己最初都低估了端侧的能力边界。去年行业普遍认为Agen至少需要1T到2T参数的云端巨型模型才能胜任,但实际上,面壁上一代仅2B规模的模型就已展现出Agent能力的雏形,如今35B-A3B模型更让端侧Agent有了坚实保障。“一个一两T的云端模型能达到的能力,端侧模型理论上都能做得到,只是时间问题。”
而在技术路线之外,如何将端侧能力转化为实际的商业回报,同样是外界关注的焦点。面对今年DeepSeek等模型凭借开源斩获高商业回报的行业趋势,有媒体提问,坚持将核心端侧模型开源的面壁智能,究竟如何看待开源的商业价值?
在姚远看来,开源与商业化不仅不矛盾,反而是一条被充分验证的高效获客路径:“开源本身就是服务商业化很好的一个做法。关心端侧领域的团队都会来测现在最好的开源模型,我们现在的很多商业客户,正是因为先在社区里用了我们的开源模型、觉得效果很好,才主动找过来接触的。”他指出,开源让技术影响力直接转化为了最精准的商业化线索。
从底层模型破局,到开源生态播种,再到软硬协同商业化结果,面壁智能正试图在端侧智能“撞线”的前夜,跑通一个技术与商业正向循环的闭环。
本文属于原创文章,如若转载,请注明来源:面壁智能姚远:35B多模态模型跑进手机,端侧智能已至“撞线前夜”https://mobile.zol.com.cn/1271/12713286.html